外观
检查点在每个超步(super-step)保存图状态的快照,并按线程组织。使用检查点编译图,即可启用人在回路工作流、时间旅行调试、容错执行和对话记忆。

INFO
Agent Server 会自动处理检查点持久化 使用 Agent Server 时,你无需手动实现或配置检查点。服务器会在后台为你处理所有持久化基础设施。
为什么要使用检查点
以下功能都需要使用检查点:
- 人在回路:检查点通过允许人员检查、中断和批准图步骤来促进人在回路工作流。这些工作流需要检查点,因为人员必须能够在任何时间点查看图的状态,而图必须能够在人员对状态进行任何更新后恢复执行。示例请参阅中断。
- 记忆:检查点允许交互之间存在"记忆"。在重复的人类交互(如对话)场景中,任何后续消息都可以发送到该线程,线程将保留对先前消息的记忆。有关如何使用检查点添加和管理对话记忆的信息,请参阅添加记忆。
- 时间旅行:检查点允许"时间旅行",让用户能够重放先前的图执行,以审查和/或调试特定的图步骤。此外,检查点还使得在任意检查点处派生(fork)图状态以探索替代轨迹成为可能。
- 容错:检查点持久化提供了容错和错误恢复能力:如果给定超步中有一个或多个节点失败,你可以从最后成功的步骤重新启动图。
- 待处理写入:当图节点在给定的超步中执行到一半失败时,LangGraph 会存储该超步中其他成功完成节点产生的待处理检查点写入。当你从该超步恢复图执行时,不会重新运行那些成功的节点。
核心概念
线程
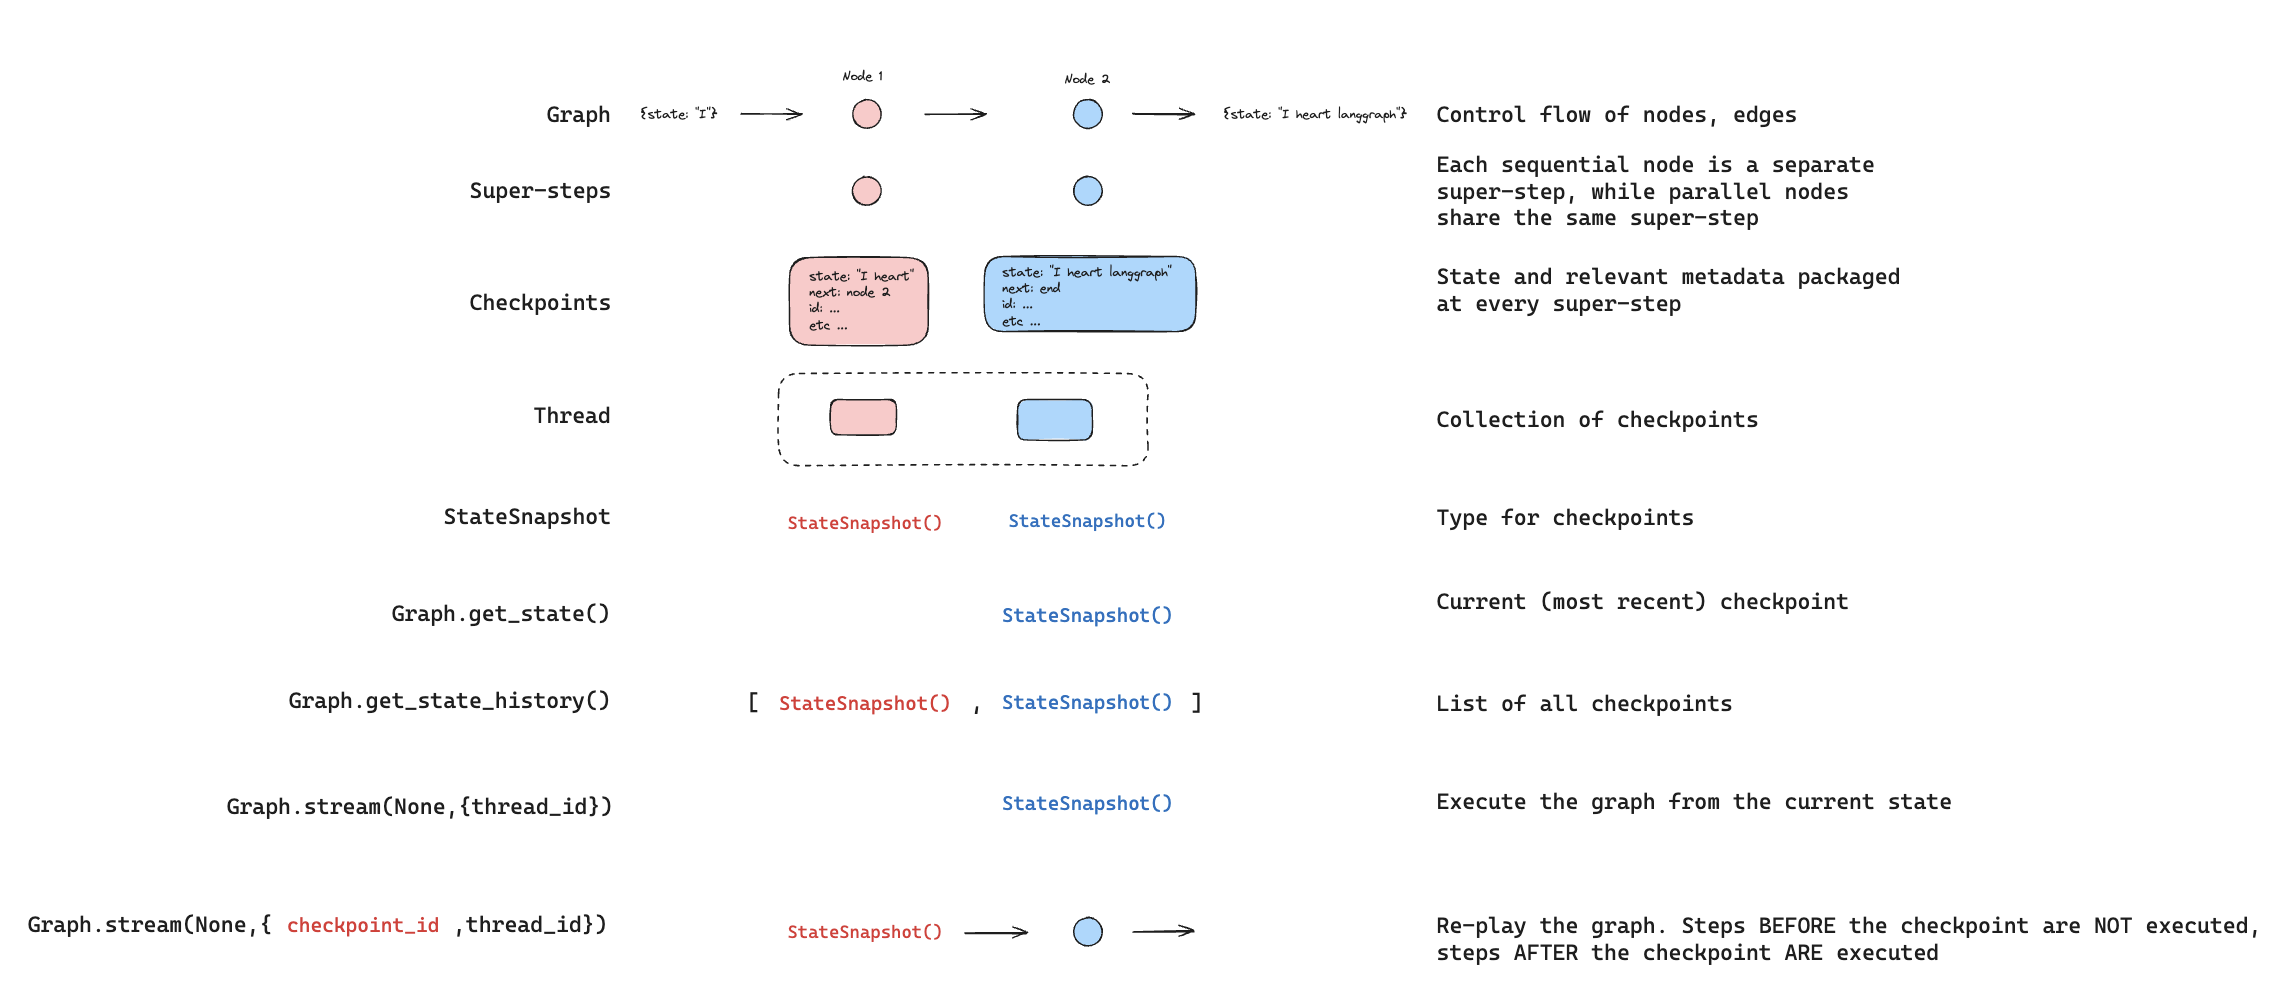
线程是检查点分配给每个已保存检查点的唯一 ID 或线程标识符。它包含一系列运行累积的状态。当一次运行被执行时,智能体底层图的状态会被持久化到线程中。
在使用检查点调用图时,你必须在配置的 configurable 部分指定 thread_id:
python
{"configurable": {"thread_id": "1"}}typescript
{
  configurable: {
    thread_id: "1";
  }
}
可以检索线程的当前和历史状态。要持久化状态,必须在执行运行之前创建线程。LangSmith API 提供了多个用于创建和管理线程及线程状态的端点。更多细节请参阅 API 参考。
检查点使用 thread_id 作为存储和检索检查点的主键。没有它,检查点就无法保存状态或在中断后恢复执行,因为检查点使用 thread_id 加载已保存的状态。
检查点
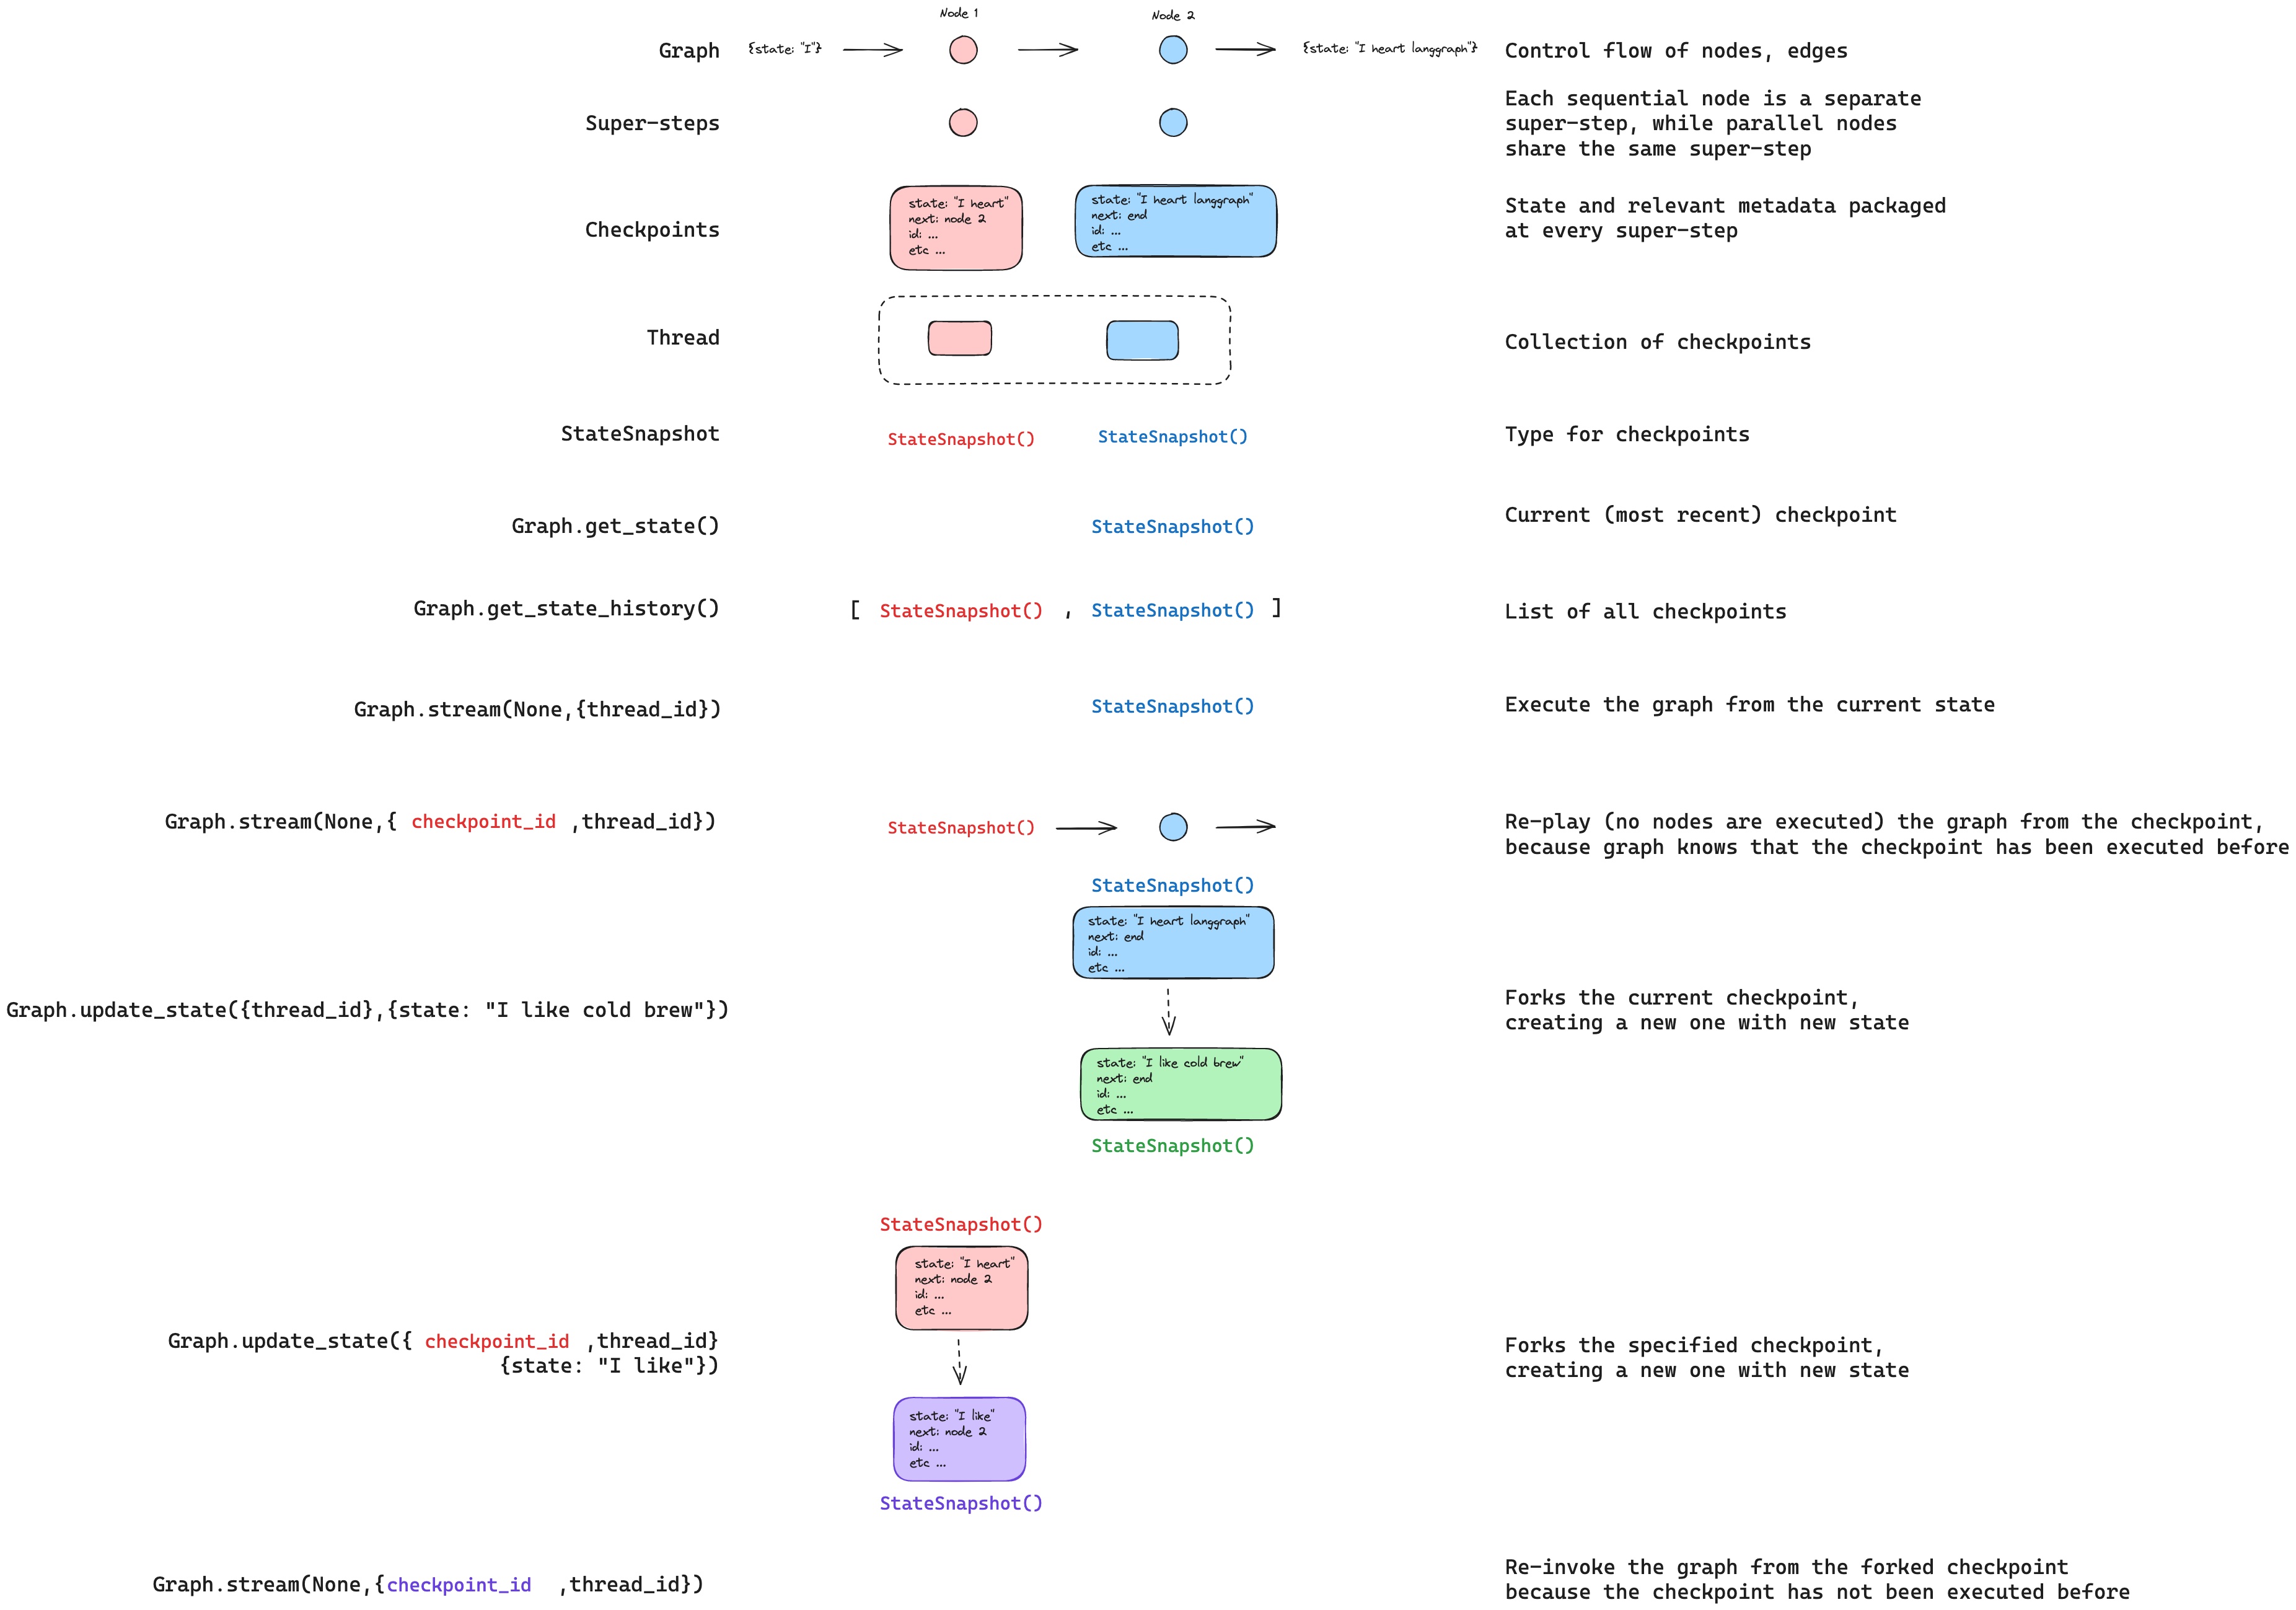
线程在特定时间点的状态称为检查点。检查点是每个超步保存的图状态快照,由 StateSnapshot 对象表示(完整字段参考请参阅 StateSnapshot 字段)。
超步
LangGraph 在每个超步边界创建一个检查点。超步是图的一次"tick",其中为该步调度的所有节点都会执行(可能并行执行)。对于像 START -> A -> B -> END 这样的顺序图,输入、节点 A 和节点 B 各有一个独立的超步——每个超步之后都会生成一个检查点。理解超步边界对于时间旅行很重要,因为你只能从检查点(即超步边界)恢复执行。
除了超步检查点之外,LangGraph 还会在节点(任务)级别持久化写入。当超步内的每个节点完成时,其输出会作为任务条目写入检查点的 checkpoint_writes 表,并与正在进行的检查点关联。正是这些按任务的写入实现了待处理写入恢复:如果同一超步中的另一个节点失败,成功节点的写入已经持久化,无需在恢复时重新运行。完整的状态快照则会在超步完成后提交。
LangGraph 还会持久化超步内各个节点执行的写入。这些写入以任务形式存储,用于容错:如果同一超步中的另一个节点失败,成功节点的写入在恢复时无需重新计算。这些任务写入不是完整的 StateSnapshot 检查点,因此时间旅行从超步边界的完整检查点恢复。
检查点会被持久化,可用于在之后恢复线程的状态。
下面我们看看以如下方式调用一个简单图时保存了哪些检查点:
python
from langgraph.graph import StateGraph, START, END
from langgraph.checkpoint.memory import InMemorySaver
from langchain_core.runnables import RunnableConfig
from typing import Annotated
from typing_extensions import TypedDict
from operator import add

class State(TypedDict):
    foo: str
    bar: Annotated[list[str], add]

def node_a(state: State):
    return {"foo": "a", "bar": ["a"]}

def node_b(state: State):
    return {"foo": "b", "bar": ["b"]}

workflow = StateGraph(State)
workflow.add_node(node_a)
workflow.add_node(node_b)
workflow.add_edge(START, "node_a")
workflow.add_edge("node_a", "node_b")
workflow.add_edge("node_b", END)

checkpointer = InMemorySaver()
graph = workflow.compile(checkpointer=checkpointer)

config: RunnableConfig = {"configurable": {"thread_id": "1"}}
graph.invoke({"foo": "", "bar":[]}, config)
typescript
import { StateGraph, StateSchema, ReducedValue, START, END, MemorySaver } from "@langchain/langgraph";
import { z } from "zod/v4";

const State = new StateSchema({
  foo: z.string(),
  bar: new ReducedValue(
    z.array(z.string()).default(() => []),
    {
      inputSchema: z.array(z.string()),
      reducer: (x, y) => x.concat(y),
    }
  ),
});

const workflow = new StateGraph(State)
  .addNode("nodeA", (state) => {
    return { foo: "a", bar: ["a"] };
  })
  .addNode("nodeB", (state) => {
    return { foo: "b", bar: ["b"] };
  })
  .addEdge(START, "nodeA")
  .addEdge("nodeA", "nodeB")
  .addEdge("nodeB", END);

const checkpointer = new MemorySaver();
const graph = workflow.compile({ checkpointer });

const config = { configurable: { thread_id: "1" } };
await graph.invoke({ foo: "", bar: [] }, config);
运行图之后,将正好有 4 个检查点:
- 空检查点,下一个要执行的节点是
START - 包含用户输入
{'foo': '', 'bar': []}的检查点,下一个要执行的节点是node_a - 包含
node_a输出{'foo': 'a', 'bar': ['a']}的检查点,下一个要执行的节点是node_b - 包含
node_b输出{'foo': 'b', 'bar': ['a', 'b']}的检查点,没有下一个要执行的节点
请注意,bar 通道的值包含两个节点的输出,因为此示例为 bar 通道设置了 reducer。
运行图之后,将正好有 4 个检查点:
- 空检查点,下一个要执行的节点是
START - 包含用户输入
{'foo': '', 'bar': []}的检查点,下一个要执行的节点是nodeA - 包含
nodeA输出{'foo': 'a', 'bar': ['a']}的检查点,下一个要执行的节点是nodeB - 包含
nodeB输出{'foo': 'b', 'bar': ['a', 'b']}的检查点,没有下一个要执行的节点
请注意,bar 通道的值包含两个节点的输出,因为此示例为 bar 通道设置了 reducer。
检查点命名空间
每个检查点都有一个 checkpoint_ns(检查点命名空间)字段,用于标识它属于哪个图或子图:
""(空字符串):检查点属于父(根)图。"node_name:uuid":检查点属于以给定节点调用的子图。对于嵌套子图,命名空间用|分隔符连接(例如"outer_node:uuid|inner_node:uuid")。
你可以通过配置在节点内访问检查点命名空间:
python
from langchain_core.runnables import RunnableConfig

def my_node(state: State, config: RunnableConfig):
    checkpoint_ns = config["configurable"]["checkpoint_ns"]
    # "" 用于父图,"node_name:uuid" 用于子图
typescript
import { RunnableConfig } from "@langchain/core/runnables";

function myNode(state: typeof State.Type, config: RunnableConfig) {
  const checkpointNs = config.configurable?.checkpoint_ns;
  // "" 用于父图,"node_name:uuid" 用于子图
}有关处理子图状态和检查点的更多细节,请参阅子图。
获取和更新状态
获取状态
与已保存的图状态交互时,你必须指定线程标识符。你可以通过调用 graph.get_state(config) 查看图的_最新_状态。这将返回一个 StateSnapshot 对象,它对应于配置中提供的线程 ID 关联的最新检查点,如果提供了检查点 ID,则对应于该线程的某个检查点 ID 关联的检查点。
python
# 获取最新的状态快照
config = {"configurable": {"thread_id": "1"}}
graph.get_state(config)

# 获取特定 checkpoint_id 的状态快照
config = {"configurable": {"thread_id": "1", "checkpoint_id": "1ef663ba-28fe-6528-8002-5a559208592c"}}
graph.get_state(config)与已保存的图状态交互时,你必须指定线程标识符。你可以通过调用 graph.getState(config) 查看图的_最新_状态。这将返回一个 StateSnapshot 对象,它对应于配置中提供的线程 ID 关联的最新检查点,如果提供了检查点 ID,则对应于该线程的某个检查点 ID 关联的检查点。
typescript
// 获取最新的状态快照
const config = { configurable: { thread_id: "1" } };
await graph.getState(config);

// 获取特定 checkpoint_id 的状态快照
const config = {
  configurable: {
    thread_id: "1",
    checkpoint_id: "1ef663ba-28fe-6528-8002-5a559208592c",
  },
};
await graph.getState(config);在此示例中,get_state 的输出将如下所示:
StateSnapshot(
    values={'foo': 'b', 'bar': ['a', 'b']},
    next=(),
    config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28fe-6528-8002-5a559208592c'}},
    metadata={'source': 'loop', 'writes': {'node_b': {'foo': 'b', 'bar': ['b']}}, 'step': 2},
    created_at='2024-08-29T19:19:38.821749+00:00',
    parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f9-6ec4-8001-31981c2c39f8'}}, tasks=()
)在此示例中,getState 的输出将如下所示:
StateSnapshot {
  values: { foo: 'b', bar: ['a', 'b'] },
  next: [],
  config: {
    configurable: {
      thread_id: '1',
      checkpoint_ns: '',
      checkpoint_id: '1ef663ba-28fe-6528-8002-5a559208592c'
    }
  },
  metadata: {
    source: 'loop',
    writes: { nodeB: { foo: 'b', bar: ['b'] } },
    step: 2
  },
  createdAt: '2024-08-29T19:19:38.821749+00:00',
  parentConfig: {
    configurable: {
      thread_id: '1',
      checkpoint_ns: '',
      checkpoint_id: '1ef663ba-28f9-6ec4-8001-31981c2c39f8'
    }
  },
  tasks: []
}
StateSnapshot 字段
| 字段 | 类型 | 描述 |
|---|---|---|
values | dict | 此检查点处的状态通道值。 |
next | tuple[str, ...] | 接下来要执行的节点名称。空的 () 表示图已完成。 |
config | dict | 包含 thread_id、checkpoint_ns 和 checkpoint_id。 |
metadata | dict | 执行元数据。包含 source("input"、"loop" 或 "update")、writes(节点输出)和 step(超步计数器)。 |
created_at | str | 此检查点创建时的 ISO 8601 时间戳。 |
parent_config | dict | None | 上一个检查点的配置。第一个检查点为 None。 |
tasks | tuple[PregelTask, ...] | 此步要执行的任务。每个任务都有 id、name、error、interrupts,并且可选地包含 state(子图快照,在使用 subgraphs=True 时)。 |
| 字段 | 类型 | 描述 |
|---|---|---|
values | object | 此检查点处的状态通道值。 |
next | string[] | 接下来要执行的节点名称。空的 [] 表示图已完成。 |
config | object | 包含 thread_id、checkpoint_ns 和 checkpoint_id。 |
metadata | object | 执行元数据。包含 source("input"、"loop" 或 "update")、writes(节点输出)和 step(超步计数器)。 |
createdAt | string | 此检查点创建时的 ISO 8601 时间戳。 |
parentConfig | object | null | 上一个检查点的配置。第一个检查点为 null。 |
tasks | PregelTask[] | 此步要执行的任务。每个任务都有 id、name、error、interrupts,并且可选地包含 state(子图快照,在使用 subgraphs: true 时)。 |
获取状态历史
你可以通过调用 graph.get_state_history(config) 获取给定线程的完整图执行历史。这将返回与配置中提供的线程 ID 关联的 StateSnapshot 对象列表。重要的是,检查点将按时间顺序排列,最新的检查点 / StateSnapshot 位于列表首位。
python
config = {"configurable": {"thread_id": "1"}}
list(graph.get_state_history(config))
你可以通过调用 graph.getStateHistory(config) 获取给定线程的完整图执行历史。这将返回与配置中提供的线程 ID 关联的 StateSnapshot 对象列表。重要的是,检查点将按时间顺序排列,最新的检查点 / StateSnapshot 位于列表首位。
typescript
const config = { configurable: { thread_id: "1" } };
for await (const state of graph.getStateHistory(config)) {
  console.log(state);
}在此示例中,get_state_history 的输出将如下所示:
[
    StateSnapshot(
        values={'foo': 'b', 'bar': ['a', 'b']},
        next=(),
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28fe-6528-8002-5a559208592c'}},
        metadata={'source': 'loop', 'writes': {'node_b': {'foo': 'b', 'bar': ['b']}}, 'step': 2},
        created_at='2024-08-29T19:19:38.821749+00:00',
        parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f9-6ec4-8001-31981c2c39f8'}},
        tasks=(),
    ),
    StateSnapshot(
        values={'foo': 'a', 'bar': ['a']},
        next=('node_b',),
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f9-6ec4-8001-31981c2c39f8'}},
        metadata={'source': 'loop', 'writes': {'node_a': {'foo': 'a', 'bar': ['a']}}, 'step': 1},
        created_at='2024-08-29T19:19:38.819946+00:00',
        parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f4-6b4a-8000-ca575a13d36a'}},
        tasks=(PregelTask(id='6fb7314f-f114-5413-a1f3-d37dfe98ff44', name='node_b', error=None, interrupts=()),),
    ),
    StateSnapshot(
        values={'foo': '', 'bar': []},
        next=('node_a',),
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f4-6b4a-8000-ca575a13d36a'}},
        metadata={'source': 'loop', 'writes': None, 'step': 0},
        created_at='2024-08-29T19:19:38.817813+00:00',
        parent_config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f0-6c66-bfff-6723431e8481'}},
        tasks=(PregelTask(id='f1b14528-5ee5-579c-949b-23ef9bfbed58', name='node_a', error=None, interrupts=()),),
    ),
    StateSnapshot(
        values={'bar': []},
        next=('__start__',),
        config={'configurable': {'thread_id': '1', 'checkpoint_ns': '', 'checkpoint_id': '1ef663ba-28f0-6c66-bfff-6723431e8481'}},
        metadata={'source': 'input', 'writes': {'foo': ''}, 'step': -1},
        created_at='2024-08-29T19:19:38.816205+00:00',
        parent_config=None,
        tasks=(PregelTask(id='6d27aa2e-d72b-5504-a36f-8620e54a76dd', name='__start__', error=None, interrupts=()),),
    )
]在此示例中,getStateHistory 的输出将如下所示:
[
  StateSnapshot {
    values: { foo: 'b', bar: ['a', 'b'] },
    next: [],
    config: {
      configurable: {
        thread_id: '1',
        checkpoint_ns: '',
        checkpoint_id: '1ef663ba-28fe-6528-8002-5a559208592c'
      }
    },
    metadata: {
      source: 'loop',
      writes: { nodeB: { foo: 'b', bar: ['b'] } },
      step: 2
    },
    createdAt: '2024-08-29T19:19:38.821749+00:00',
    parentConfig: {
      configurable: {
        thread_id: '1',
        checkpoint_ns: '',
        checkpoint_id: '1ef663ba-28f9-6ec4-8001-31981c2c39f8'
      }
    },
    tasks: []
  },
  StateSnapshot {
    values: { foo: 'a', bar: ['a'] },
    next: ['nodeB'],
    config: {
      configurable: {
        thread_id: '1',
        checkpoint_ns: '',
        checkpoint_id: '1ef663ba-28f9-6ec4-8001-31981c2c39f8'
      }
    },
    metadata: {
      source: 'loop',
      writes: { nodeA: { foo: 'a', bar: ['a'] } },
      step: 1
    },
    createdAt: '2024-08-29T19:19:38.819946+00:00',
    parentConfig: {
      configurable: {
        thread_id: '1',
        checkpoint_ns: '',
        checkpoint_id: '1ef663ba-28f4-6b4a-8000-ca575a13d36a'
      }
    },
    tasks: [
      PregelTask {
        id: '6fb7314f-f114-5413-a1f3-d37dfe98ff44',
        name: 'nodeB',
        error: null,
        interrupts: []
      }
    ]
  },
  StateSnapshot {
    values: { foo: '', bar: [] },
    next: ['node_a'],
    config: {
      configurable: {
        thread_id: '1',
        checkpoint_ns: '',
        checkpoint_id: '1ef663ba-28f4-6b4a-8000-ca575a13d36a'
      }
    },
    metadata: {
      source: 'loop',
      writes: null,
      step: 0
    },
    createdAt: '2024-08-29T19:19:38.817813+00:00',
    parentConfig: {
      configurable: {
        thread_id: '1',
        checkpoint_ns: '',
        checkpoint_id: '1ef663ba-28f0-6c66-bfff-6723431e8481'
      }
    },
    tasks: [
      PregelTask {
        id: 'f1b14528-5ee5-579c-949b-23ef9bfbed58',
        name: 'node_a',
        error: null,
        interrupts: []
      }
    ]
  },
  StateSnapshot {
    values: { bar: [] },
    next: ['__start__'],
    config: {
      configurable: {
        thread_id: '1',
        checkpoint_ns: '',
        checkpoint_id: '1ef663ba-28f0-6c66-bfff-6723431e8481'
      }
    },
    metadata: {
      source: 'input',
      writes: { foo: '' },
      step: -1
    },
    createdAt: '2024-08-29T19:19:38.816205+00:00',
    parentConfig: null,
    tasks: [
      PregelTask {
        id: '6d27aa2e-d72b-5504-a36f-8620e54a76dd',
        name: '__start__',
        error: null,
        interrupts: []
      }
    ]
  }
]
查找特定检查点
你可以过滤状态历史,以查找匹配特定条件的检查点:
python
history = list(graph.get_state_history(config))

# 找到特定节点执行之前的检查点
before_node_b = next(s for s in history if s.next == ("node_b",))

# 按步数查找检查点
step_2 = next(s for s in history if s.metadata["step"] == 2)

# 查找由 update_state 创建的检查点
forks = [s for s in history if s.metadata["source"] == "update"]

# 找到发生中断的检查点
interrupted = next(
    s for s in history
    if s.tasks and any(t.interrupts for t in s.tasks)
)
typescript
const history: StateSnapshot[] = [];
for await (const state of graph.getStateHistory(config)) {
  history.push(state);
}

// 找到特定节点执行之前的检查点
const beforeNodeB = history.find((s) => s.next.includes("nodeB"));

// 按步数查找检查点
const step2 = history.find((s) => s.metadata.step === 2);

// 查找由 updateState 创建的检查点
const forks = history.filter((s) => s.metadata.source === "update");

// 找到发生中断的检查点
const interrupted = history.find(
  (s) => s.tasks.length > 0 && s.tasks.some((t) => t.interrupts.length > 0)
);
重放
重放会从先前的检查点重新执行步骤。使用先前的 checkpoint_id 调用图,以重新运行该检查点之后的节点。检查点之前的节点会被跳过(其结果已保存)。检查点之后的节点会重新执行,包括任何 LLM 调用、API 请求或中断——它们在重放期间总是会被重新触发。
有关重放过去执行的完整细节和代码示例,请参阅时间旅行。
更新状态
你可以使用 update_state 编辑图状态。这会创建一个包含更新值的新检查点——它不会修改原始检查点。该更新与节点更新同样处理:值在定义有 reducer 函数时会被传入 reducer,因此带 reducer 的通道会_累积_值而不是覆盖它们。
你可以选择指定 as_node 来控制更新被视为来自哪个节点,这会影响接下来执行哪个节点。有关细节请参阅时间旅行:as_node。
你可以使用 graph.updateState() 编辑图状态。这会创建一个包含更新值的新检查点——它不会修改原始检查点。该更新与节点更新同样处理:值在定义有 reducer 函数时会被传入 reducer,因此带 reducer 的通道会_累积_值而不是覆盖它们。
你可以选择指定 asNode 来控制更新被视为来自哪个节点,这会影响接下来执行哪个节点。有关细节请参阅时间旅行:asNode。
持久性模式
LangGraph 支持三种持久性模式,让你能够平衡性能和数据一致性。你可以在调用任何图执行方法时指定持久性模式:
python
graph.stream(
    {"input": "test"},
    durability="sync"
)
typescript
await graph.stream(
  { input: "test" },
  { durability: "sync" }
)
持久性模式从低到高排列如下:
"exit":LangGraph 仅在图执行退出时持久化更改——成功退出、出错退出或由于人在回路中断退出。这为长时间运行的图提供了最佳性能,但意味着中间状态不会保存,因此你无法在执行过程中从系统故障(如进程崩溃)中恢复。"async":LangGraph 在下一步执行的同时异步持久化更改。这提供了良好的性能和持久性,但如果进程在执行过程中崩溃,存在 LangGraph 未能写入检查点的小风险。"sync":LangGraph 在下一步开始之前同步持久化更改。这确保了 LangGraph 在继续执行之前写入每个检查点,以一定的性能开销为代价提供了高持久性。
优化检查点存储
默认情况下,LangGraph 检查点会在每个超步写入每个状态通道的完整值。对于累积量大的长时间运行线程——例如多轮对话——这可能会随着时间推移产生显著的增长存储。
DeltaChannel 只存储增量而不是完整的累积值,大幅减小了追加密集型通道的检查点大小。有关用法以及存储与延迟之间的权衡,请参阅 DeltaChannel。
WARNING
DeltaChannel 需要 langgraph>=1.2,目前处于 beta 阶段。API 在未来的版本中可能会发生变化。
检查点库
在底层,检查点持久化由符合 BaseCheckpointSaver 接口的检查点对象驱动。LangGraph 提供了多个检查点实现,所有实现都通过独立、可安装的库来提供。
INFO
可用的提供商请参阅检查点集成。
langgraph-checkpoint:检查点保存器的基本接口(BaseCheckpointSaver)以及序列化/反序列化接口(SerializerProtocol)。包含用于实验的内存检查点实现(InMemorySaver)。LangGraph 自带了langgraph-checkpoint。langgraph-checkpoint-sqlite:使用 SQLite 数据库的 LangGraph 检查点实现(SqliteSaver/AsyncSqliteSaver)。非常适合实验和本地工作流。需要单独安装。langgraph-checkpoint-postgres:使用 Postgres 数据库的高级检查点(PostgresSaver/AsyncPostgresSaver),在 LangSmith 中使用。非常适合生产环境使用。需要单独安装。langchain-azure-cosmosdb:使用 Azure Cosmos DB for NoSQL 的 LangGraph 检查点实现(CosmosDBSaverSync/CosmosDBSaver)。非常适合在 Azure 生产环境中使用。支持同步和异步操作,并支持 Microsoft Entra ID 身份验证。需要单独安装。@langchain/langgraph-checkpoint:检查点保存器的基本接口(BaseCheckpointSaver)以及序列化/反序列化接口(SerializerProtocol)。包含用于实验的内存检查点实现(MemorySaver)。LangGraph 自带了@langchain/langgraph-checkpoint。@langchain/langgraph-checkpoint-sqlite:使用 SQLite 数据库的 LangGraph 检查点实现(SqliteSaver)。非常适合实验和本地工作流。需要单独安装。@langchain/langgraph-checkpoint-postgres:使用 Postgres 数据库的高级检查点(PostgresSaver),在 LangSmith 中使用。非常适合生产环境使用。需要单独安装。@langchain/langgraph-checkpoint-mongodb:由 MongoDB 支持的高级检查点(MongoDBSaver)和长期记忆存储(MongoDBStore)。该存储支持跨线程持久化,并可选择集成向量搜索。非常适合生产环境使用。需要单独安装。@langchain/langgraph-checkpoint-redis:使用 Redis 数据库的高级检查点(RedisSaver)。非常适合生产环境使用。需要单独安装。
检查点接口
每个检查点都符合 BaseCheckpointSaver 接口,并实现以下方法:
.put— 存储带有其配置和元数据的检查点。.put_writes— 存储与检查点关联的中间写入(即待处理写入)。.get_tuple— 针对给定配置(thread_id和checkpoint_id)获取检查点元组。用于填充graph.get_state()中的StateSnapshot。.list— 列出匹配给定配置和过滤条件的检查点。用于填充graph.get_state_history()中的状态历史
如果检查点与异步图执行一起使用(即通过 .ainvoke、.astream、.abatch 执行图),将使用上述方法的异步版本(.aput、.aput_writes、.aget_tuple、.alist)。
INFO
要以异步方式运行图,你可以使用 InMemorySaver,或 Sqlite/Postgres 检查点的异步版本——AsyncSqliteSaver / AsyncPostgresSaver 检查点。
每个检查点都符合 BaseCheckpointSaver 接口,并实现以下方法:
.put— 存储带有其配置和元数据的检查点。.putWrites— 存储与检查点关联的中间写入(即待处理写入)。.getTuple— 针对给定配置(thread_id和checkpoint_id)获取检查点元组。用于填充graph.getState()中的StateSnapshot。.list— 列出匹配给定配置和过滤条件的检查点。用于填充graph.getStateHistory()中的状态历史
序列化器
检查点保存图状态时,需要对状态中的通道值进行序列化。这是通过序列化器对象完成的。
langgraph_checkpoint 定义了用于实现序列化器的 protocol,并提供了一个默认实现(JsonPlusSerializer),它处理多种类型,包括 LangChain 和 LangGraph 原语、日期时间、枚举等。
使用 pickle 进行序列化
默认的序列化器 JsonPlusSerializer 在底层使用 ormsgpack 和 JSON,这并不适合所有类型的对象。
如果你希望针对 msgpack 编码器当前不支持的对象(例如 Pandas 数据框)回退到 pickle,可以使用 JsonPlusSerializer 的 pickle_fallback 参数:
python
from langgraph.checkpoint.memory import InMemorySaver
from langgraph.checkpoint.serde.jsonplus import JsonPlusSerializer

# ... 定义图 ...
graph.compile(
    checkpointer=InMemorySaver(serde=JsonPlusSerializer(pickle_fallback=True))
)
加密
检查点可以选择加密所有持久化的状态。要启用此功能,请将 EncryptedSerializer 的实例传递给任何 BaseCheckpointSaver 实现的 serde 参数。创建加密序列化器最简单的方式是通过 from_pycryptodome_aes,它会从 LANGGRAPH_AES_KEY 环境变量读取 AES 密钥(或接受 key 参数):
python
import sqlite3

from langgraph.checkpoint.serde.encrypted import EncryptedSerializer
from langgraph.checkpoint.sqlite import SqliteSaver

serde = EncryptedSerializer.from_pycryptodome_aes()  # reads LANGGRAPH_AES_KEY
checkpointer = SqliteSaver(sqlite3.connect("checkpoint.db"), serde=serde)
python
from langgraph.checkpoint.serde.encrypted import EncryptedSerializer
from langgraph.checkpoint.postgres import PostgresSaver

serde = EncryptedSerializer.from_pycryptodome_aes()
checkpointer = PostgresSaver.from_conn_string("postgresql://...", serde=serde)
checkpointer.setup()
在 LangSmith 上运行时,只要存在 LANGGRAPH_AES_KEY,就会自动启用加密,因此你只需要提供环境变量即可。可以通过实现 CipherProtocol 并将其提供给 EncryptedSerializer 来使用其他加密方案。
构建自定义检查点
TIP
构建时使用一致性测试套件验证你的实现。它覆盖了全部五个基础方法以及包括 delta 通道在内的扩展能力。发布前请在 CI 中运行它。
本节介绍为自定义存储后端从头实现 BaseCheckpointSaver。如果你已经有一个可用的检查点,只需要添加 delta 通道支持,请直接跳转到Delta 通道支持。
概述
LangGraph 的持久化层建立在两个存储抽象之上:
- 检查点表 — 每个超步一行;存储序列化后的图状态(
channel_values、channel_versions、versions_seen)并链接到其父检查点。 - 写入表 — 超步内每个节点输出一行;存储与检查点关联的
(task_id, channel, value)元组。
你的检查点管理这两个表。put 写入检查点行;put_writes 写入节点输出行;get_tuple 将两者读取回 CheckpointTuple。
基础契约
继承 BaseCheckpointSaver 并实现这五个方法。所有方法都是必需的——缺失的基础方法会在运行时抛出 NotImplementedError。
python
from collections.abc import AsyncIterator, Iterator, Sequence
from typing import Any
from langchain_core.runnables import RunnableConfig
from langgraph.checkpoint.base import (
    BaseCheckpointSaver,
    ChannelVersions,
    Checkpoint,
    CheckpointMetadata,
    CheckpointTuple,
)

class MyCheckpointer(BaseCheckpointSaver):
    async def aput(
        self,
        config: RunnableConfig,
        checkpoint: Checkpoint,
        metadata: CheckpointMetadata,
        new_versions: ChannelVersions,
    ) -> RunnableConfig:
        ...

    async def aput_writes(
        self,
        config: RunnableConfig,
        writes: Sequence[tuple[str, Any]],
        task_id: str,
        task_path: str = "",
    ) -> None:
        ...

    async def aget_tuple(self, config: RunnableConfig) -> CheckpointTuple | None:
        ...

    async def alist(
        self,
        config: RunnableConfig | None,
        *,
        filter: dict[str, Any] | None = None,
        before: RunnableConfig | None = None,
        limit: int | None = None,
    ) -> AsyncIterator[CheckpointTuple]:
        ...
        yield  # 使其成为异步生成器

    async def adelete_thread(self, thread_id: str) -> None:
        ...
put / aput
存储一行检查点。返回包含已存储 checkpoint_id 的更新配置。
关键要求:
- 使用
self.serde.dumps_typed(checkpoint)序列化检查点——这会处理所有 LangGraph 原生类型,包括 delta 通道使用的_DeltaSnapshotblob。 - 完整存储
metadata——不要剥离未知键。LangGraph 会在次要版本中添加新的元数据字段(例如 delta 通道的counters_since_delta_snapshot);丢弃它们会静默破坏功能。 - 将
config["configurable"].get("checkpoint_id")存储为父检查点 ID,以便get_tuple能够填充parent_config。
python
async def aput(self, config, checkpoint, metadata, new_versions):
    thread_id = config["configurable"]["thread_id"]
    checkpoint_ns = config["configurable"]["checkpoint_ns"]
    checkpoint_id = checkpoint["id"]
    parent_id = config["configurable"].get("checkpoint_id")

    type_, blob = self.serde.dumps_typed(checkpoint)
    serialized_metadata = self.serde.dumps_typed(metadata)

    await self.db.execute(
        "INSERT INTO checkpoints (...) VALUES (...)",
        thread_id, checkpoint_ns, checkpoint_id, parent_id,
        type_, blob, *serialized_metadata,
    )
    return {
        "configurable": {
            "thread_id": thread_id,
            "checkpoint_ns": checkpoint_ns,
            "checkpoint_id": checkpoint_id,
        }
    }
put_writes / aput_writes
存储当前超步内单个任务的节点输出行。这些行通过 (thread_id, checkpoint_ns, checkpoint_id) 与检查点关联。
python
async def aput_writes(self, config, writes, task_id, task_path=""):
    thread_id = config["configurable"]["thread_id"]
    checkpoint_ns = config["configurable"]["checkpoint_ns"]
    checkpoint_id = config["configurable"]["checkpoint_id"]

    rows = []
    for idx, (channel, value) in enumerate(writes):
        type_, blob = self.serde.dumps_typed(value)
        final_idx = WRITES_IDX_MAP.get(channel, idx)
        rows.append((thread_id, checkpoint_ns, checkpoint_id,
                      task_id, task_path, final_idx, channel, type_, blob))

    await self.db.executemany("INSERT INTO writes (...) VALUES (...)", rows)
从 langgraph.checkpoint.base 导入 WRITES_IDX_MAP。它将特殊通道(__error__、__interrupt__ 等)映射到保留的负索引,以便它们不与常规写入索引冲突。
get_tuple / aget_tuple
检索一个检查点。配置可能包含:
- 无
checkpoint_id— 返回该线程 + 命名空间的最新检查点。 - 有特定的
checkpoint_id— 返回那个确切的检查点。
两条路径都必须正确工作。 特定 ID 路径用于时间旅行,并且——关键的是——用于每次图调用时的 delta 通道状态重建(参见Delta 通道支持)。损坏的特定 ID 查找会静默破坏 delta 通道状态。
python
async def aget_tuple(self, config):
    thread_id = config["configurable"]["thread_id"]
    checkpoint_ns = config["configurable"].get("checkpoint_ns", "")
    checkpoint_id = config["configurable"].get("checkpoint_id")

    if checkpoint_id:
        row = await self.db.fetchone(
            "SELECT * FROM checkpoints "
            "WHERE thread_id=? AND checkpoint_ns=? AND checkpoint_id=?",
            thread_id, checkpoint_ns, checkpoint_id,
        )
    else:
        row = await self.db.fetchone(
            "SELECT * FROM checkpoints "
            "WHERE thread_id=? AND checkpoint_ns=? "
            "ORDER BY checkpoint_id DESC LIMIT 1",
            thread_id, checkpoint_ns,
        )

    if row is None:
        return None

    writes = await self.db.fetchall(
        "SELECT task_id, channel, type, value FROM writes "
        "WHERE thread_id=? AND checkpoint_ns=? AND checkpoint_id=? "
        "ORDER BY task_id, idx",
        thread_id, checkpoint_ns, row["checkpoint_id"],
    )
    pending_writes = [
        (w["task_id"], w["channel"], self.serde.loads_typed((w["type"], w["value"])))
        for w in writes
    ]

    checkpoint = self.serde.loads_typed((row["type"], row["blob"]))
    metadata = self.serde.loads_typed((row["metadata_type"], row["metadata"]))

    parent_config = None
    if row["parent_checkpoint_id"]:
        parent_config = {
            "configurable": {
                "thread_id": thread_id,
                "checkpoint_ns": checkpoint_ns,
                "checkpoint_id": row["parent_checkpoint_id"],
            }
        }

    return CheckpointTuple(
        config={
            "configurable": {
                "thread_id": thread_id,
                "checkpoint_ns": checkpoint_ns,
                "checkpoint_id": row["checkpoint_id"],
            }
        },
        checkpoint=checkpoint,
        metadata=metadata,
        parent_config=parent_config,
        pending_writes=pending_writes,
    )
WARNING
行键 / 索引设计对特定 ID 查找至关重要。 如果你的存储使用不嵌入 checkpoint_id 的时间排序键(例如反转的时间戳),你就无法按 ID 直接读取行。你必须将 checkpoint_id 编码到行键中,或者建立二级索引。每次查找都使用值过滤器进行扫描虽然可行,但无法扩展。
list / alist
返回线程的检查点,最新的在前。遵守 before(只返回早于该配置 checkpoint_id 的检查点)和 limit。
delete_thread / adelete_thread
删除线程的所有检查点和写入。检查点行和写入行都必须删除。
行键 / 索引设计
你存储和索引检查点的方式直接影响正确性和性能。
推荐模式(SQL):
sql
CREATE TABLE checkpoints (
    thread_id          TEXT NOT NULL,
    checkpoint_ns      TEXT NOT NULL DEFAULT '',
    checkpoint_id      TEXT NOT NULL,   -- ULID,按字典序排序,最新的在最后
    parent_checkpoint_id TEXT,
    type               TEXT,
    checkpoint         BYTEA,
    metadata           JSONB,
    PRIMARY KEY (thread_id, checkpoint_ns, checkpoint_id)
);

CREATE TABLE writes (
    thread_id     TEXT NOT NULL,
    checkpoint_ns TEXT NOT NULL DEFAULT '',
    checkpoint_id TEXT NOT NULL,
    task_id       TEXT NOT NULL,
    task_path     TEXT NOT NULL DEFAULT '',
    idx           INTEGER NOT NULL,
    channel       TEXT NOT NULL,
    type          TEXT,
    value         BYTEA,
    PRIMARY KEY (thread_id, checkpoint_ns, checkpoint_id, task_id, task_path, idx)
);
由于 checkpoint_id 是 ULID,它按字典序排序——值越大越新。"获取最新"是 ORDER BY checkpoint_id DESC LIMIT 1;"按 ID 获取"是对主键的等值查找。
对于非 SQL 存储: 同样的原则适用。无论你使用什么键方案,按 (thread_id, checkpoint_ns, checkpoint_id) 直接查找必须是 O(1) 或接近 O(1)。避免那种只能通过扫描线程所有行来按 ID 查找检查点的设计。
序列化
始终使用 self.serde(继承自 BaseCheckpointSaver,默认为 JsonPlusSerializer)处理检查点、写入和元数据。不要直接使用 pickle 处理元数据——它虽然可用,但 JsonPlusSerializer 会产生人类可读的输出,并且能更好地处理版本管理。
JsonPlusSerializer 自动处理所有 LangGraph 原生类型:
_DeltaSnapshot— delta 通道使用的哨兵 blob(msgpack 扩展代码 7)- Pydantic v2 模型、dataclass、numpy 数组、日期时间、枚举等
如果你编写自定义序列化器,请确保它能够往返处理 langgraph.checkpoint.serde.types 中的 _DeltaSnapshot。
扩展能力
这些方法是可选的,但可以解锁额外的 Agent Server 功能。如果你的存储后端能够高效支持它们,请实现它们。
| 方法 | 启用的功能 |
|---|---|
adelete_for_runs | 多任务策略回滚 |
acopy_thread | 高效的线程派生 |
aprune | 线程历史修剪 |
aget_delta_channel_history | 高效的 delta 通道状态重建(见下文) |
Agent Server 会在启动时自动检测你的检查点实现了哪些能力,并激活相应的功能。
Delta 通道支持
INFO
DeltaChannel 目前处于 beta 阶段。 在设计稳定期间,API 和磁盘上的表示形式可能会发生变化。
DeltaChannel 是一种 reducer 通道,它在检查点 blob 中只存储哨兵(MISSING)而不是完整的通道值。状态通过将祖先写入重放经过 reducer 来重建。这使得像 messages 这样随时间累积的通道的检查点 blob 从每个步骤 O(N) 变为 O(1)。
运行时需要什么
当加载一个其 delta 通道不在 channel_values 中的检查点时,LangGraph 会调用 saver.get_delta_channel_history(config=config, channels=[...])。对于每个通道,它返回:
writes— 祖先链中对该通道的所有写入,最早的在前,直到最近的快照。seed(可选)— 最近的具有_DeltaSnapshot的祖先处存储的_DeltaSnapshotblob;如果遍历到根仍未找到快照,则缺失。
然后运行时调用 channel.from_checkpoint(seed) 和 channel.replay_writes(writes) 来重建当前值。
默认实现
BaseCheckpointSaver 提供了一个默认的 get_delta_channel_history,它适用于任何正确的 get_tuple 实现:
python
# 从 BaseCheckpointSaver 简化而来
def get_delta_channel_history(self, *, config, channels):
    target = self.get_tuple(config)          # 加载头部的检查点
    cursor = target.parent_config            # 从其父级开始遍历
    collected = {ch: [] for ch in channels}
    seed = {}
    remaining = set(channels)

    while cursor and remaining:
        tup = self.get_tuple(cursor)         # ← 需要正确的按 ID 查找
        if tup is None:
            break
        for write in reversed(tup.pending_writes or []):
            if write[1] in remaining:
                collected[write[1]].append(write)
        for ch in list(remaining):
            if ch in tup.checkpoint["channel_values"]:
                seed[ch] = tup.checkpoint["channel_values"][ch]
                remaining.discard(ch)
        cursor = tup.parent_config

    return {
        ch: {"writes": list(reversed(collected[ch])), **({"seed": seed[ch]} if ch in seed else {})}
        for ch in channels
    }
关键依赖: get_tuple(cursor) 总是以特定的 checkpoint_id(父节点的 ID)调用。如果该查找返回 None,遍历会立即停止,每个 delta 通道都会被静默重建为空,且不会报错。这就是为什么 get_tuple 中的特定 ID 路径必须正确。
性能覆盖
默认的遍历为每个祖先检查点发出一次 get_tuple 调用。对于查询支持良好的后端,覆盖 get_delta_channel_history(及其异步版本)以便通过两次查询检索祖先链和写入:
python
async def aget_delta_channel_history(self, *, config, channels):
    if not channels:
        return {}

    thread_id = config["configurable"]["thread_id"]
    checkpoint_ns = config["configurable"].get("checkpoint_ns", "")
    checkpoint_id = config["configurable"]["checkpoint_id"]

    # 阶段 1:从最新到最旧流式读取祖先,直到每个通道都有种子
    ancestors = await self.db.fetchall(
        "SELECT checkpoint_id, parent_checkpoint_id, type, checkpoint "
        "FROM checkpoints "
        "WHERE thread_id=? AND checkpoint_ns=? AND checkpoint_id < ? "
        "ORDER BY checkpoint_id DESC",
        thread_id, checkpoint_ns, checkpoint_id,
    )

    chain_by_ch: dict[str, list[str]] = {ch: [] for ch in channels}
    seed_by_ch: dict[str, Any] = {}
    remaining = set(channels)
    cur_id = config["configurable"]["checkpoint_id"]

    for row in ancestors:
        if not remaining:
            break
        parent_id = row["parent_checkpoint_id"]
        ckpt = self.serde.loads_typed((row["type"], row["checkpoint"]))
        cv = ckpt.get("channel_values") or {}
        for ch in list(remaining):
            chain_by_ch[ch].append(row["checkpoint_id"])
            if ch in cv:
                seed_by_ch[ch] = cv[ch]
                remaining.discard(ch)
        cur_id = parent_id

    # 阶段 2:通过一次查询获取每个通道祖先链的写入
    result: dict[str, DeltaChannelHistory] = {}
    for ch in channels:
        chain = chain_by_ch[ch]
        if not chain:
            entry: DeltaChannelHistory = {"writes": []}
            if ch in seed_by_ch:
                entry["seed"] = seed_by_ch[ch]
            result[ch] = entry
            continue

        write_rows = await self.db.fetchall(
            f"SELECT checkpoint_id, task_id, idx, type, value FROM writes "
            f"WHERE thread_id=? AND checkpoint_ns=? AND channel=? "
            f"AND checkpoint_id IN ({','.join('?' * len(chain))})"
            f"ORDER BY checkpoint_id, task_id, idx",
            thread_id, checkpoint_ns, ch, *chain,
        )
        writes_by_cid: dict[str, list[PendingWrite]] = {}
        for row in write_rows:
            cid = row["checkpoint_id"]
            value = self.serde.loads_typed((row["type"], row["value"]))
            writes_by_cid.setdefault(cid, []).append((row["task_id"], ch, value))

        # 链从最新到最旧排列;按从旧到新的顺序迭代以得到正确的重放顺序
        collected: list[PendingWrite] = []
        for cid in reversed(chain):
            collected.extend(writes_by_cid.get(cid, []))

        entry = {"writes": collected}
        if ch in seed_by_ch:
            entry["seed"] = seed_by_ch[ch]
        result[ch] = entry

    return result
使用 delta 通道进行修剪
DeltaChannel 的状态并不是自包含在单个检查点中的——它依赖于回溯到最近 _DeltaSnapshot 的祖先写入链。如果你实现 prune 或 delete_for_runs,你不得删除存续检查点的 delta 通道所依赖的写入行。
安全选项:
- 修剪前先遍历 — 对于你打算保留的每个检查点,遍历其祖先链,并标记直到最近
_DeltaSnapshot的所有写入行为不可删除。 - 修剪前强制生成快照 — 在你保留的检查点上重写
channel_values[ch] = _DeltaSnapshot(reconstructed_value),然后随意删除祖先。 - 跳过对 delta 通道线程的修剪 — 如果你还不需要修剪,这是最安全的短期选项。
复制带有 delta 通道的线程
实现 copy_thread 时,请复制完整的祖先链——而不仅仅是头部检查点。目标线程必须为每个 delta 通道保留回溯到至少一个 _DeltaSnapshot 的写入行,否则这些通道在复制后会重建为空。
使用一致性测试套件进行测试
langgraph-checkpoint-conformance 会根据完整契约验证你的实现,包括 delta 通道历史:
python
pip install langgraph-checkpoint-conformancepython
import asyncio
from langgraph.checkpoint.conformance import checkpointer_test, validate

@checkpointer_test(name="MyCheckpointer")
async def my_checkpointer():
    async with MyCheckpointer.create() as saver:
        yield saver

async def main():
    report = await validate(my_checkpointer)
    report.print_report()
    # 如果任何基础能力缺失或损坏,则使进程失败
    if not report.passed_all_base():
        raise RuntimeError("Checkpointer failed conformance suite")

asyncio.run(main())
该套件会自动检测你的检查点实现了哪些扩展能力(包括 aget_delta_channel_history),并为每个能力运行相关测试。发布前请将其作为 CI 的一部分运行。